Passende Sprachmodelle für die eigene Hardware finden

Wer Sprachmodelle lokal ausführen möchte, steht zunächst vor der Frage, welche Modelle auf der vorhandenen Hardware sinnvoll genutzt werden können. Neben der Größe des Modells spielen hierbei der verfügbare Speicher und die gewünschte Kontextgröße eine Rolle. Das Werkzeug llmfit hilft dabei, passende Modelle für den eigenen Rechner zu finden.
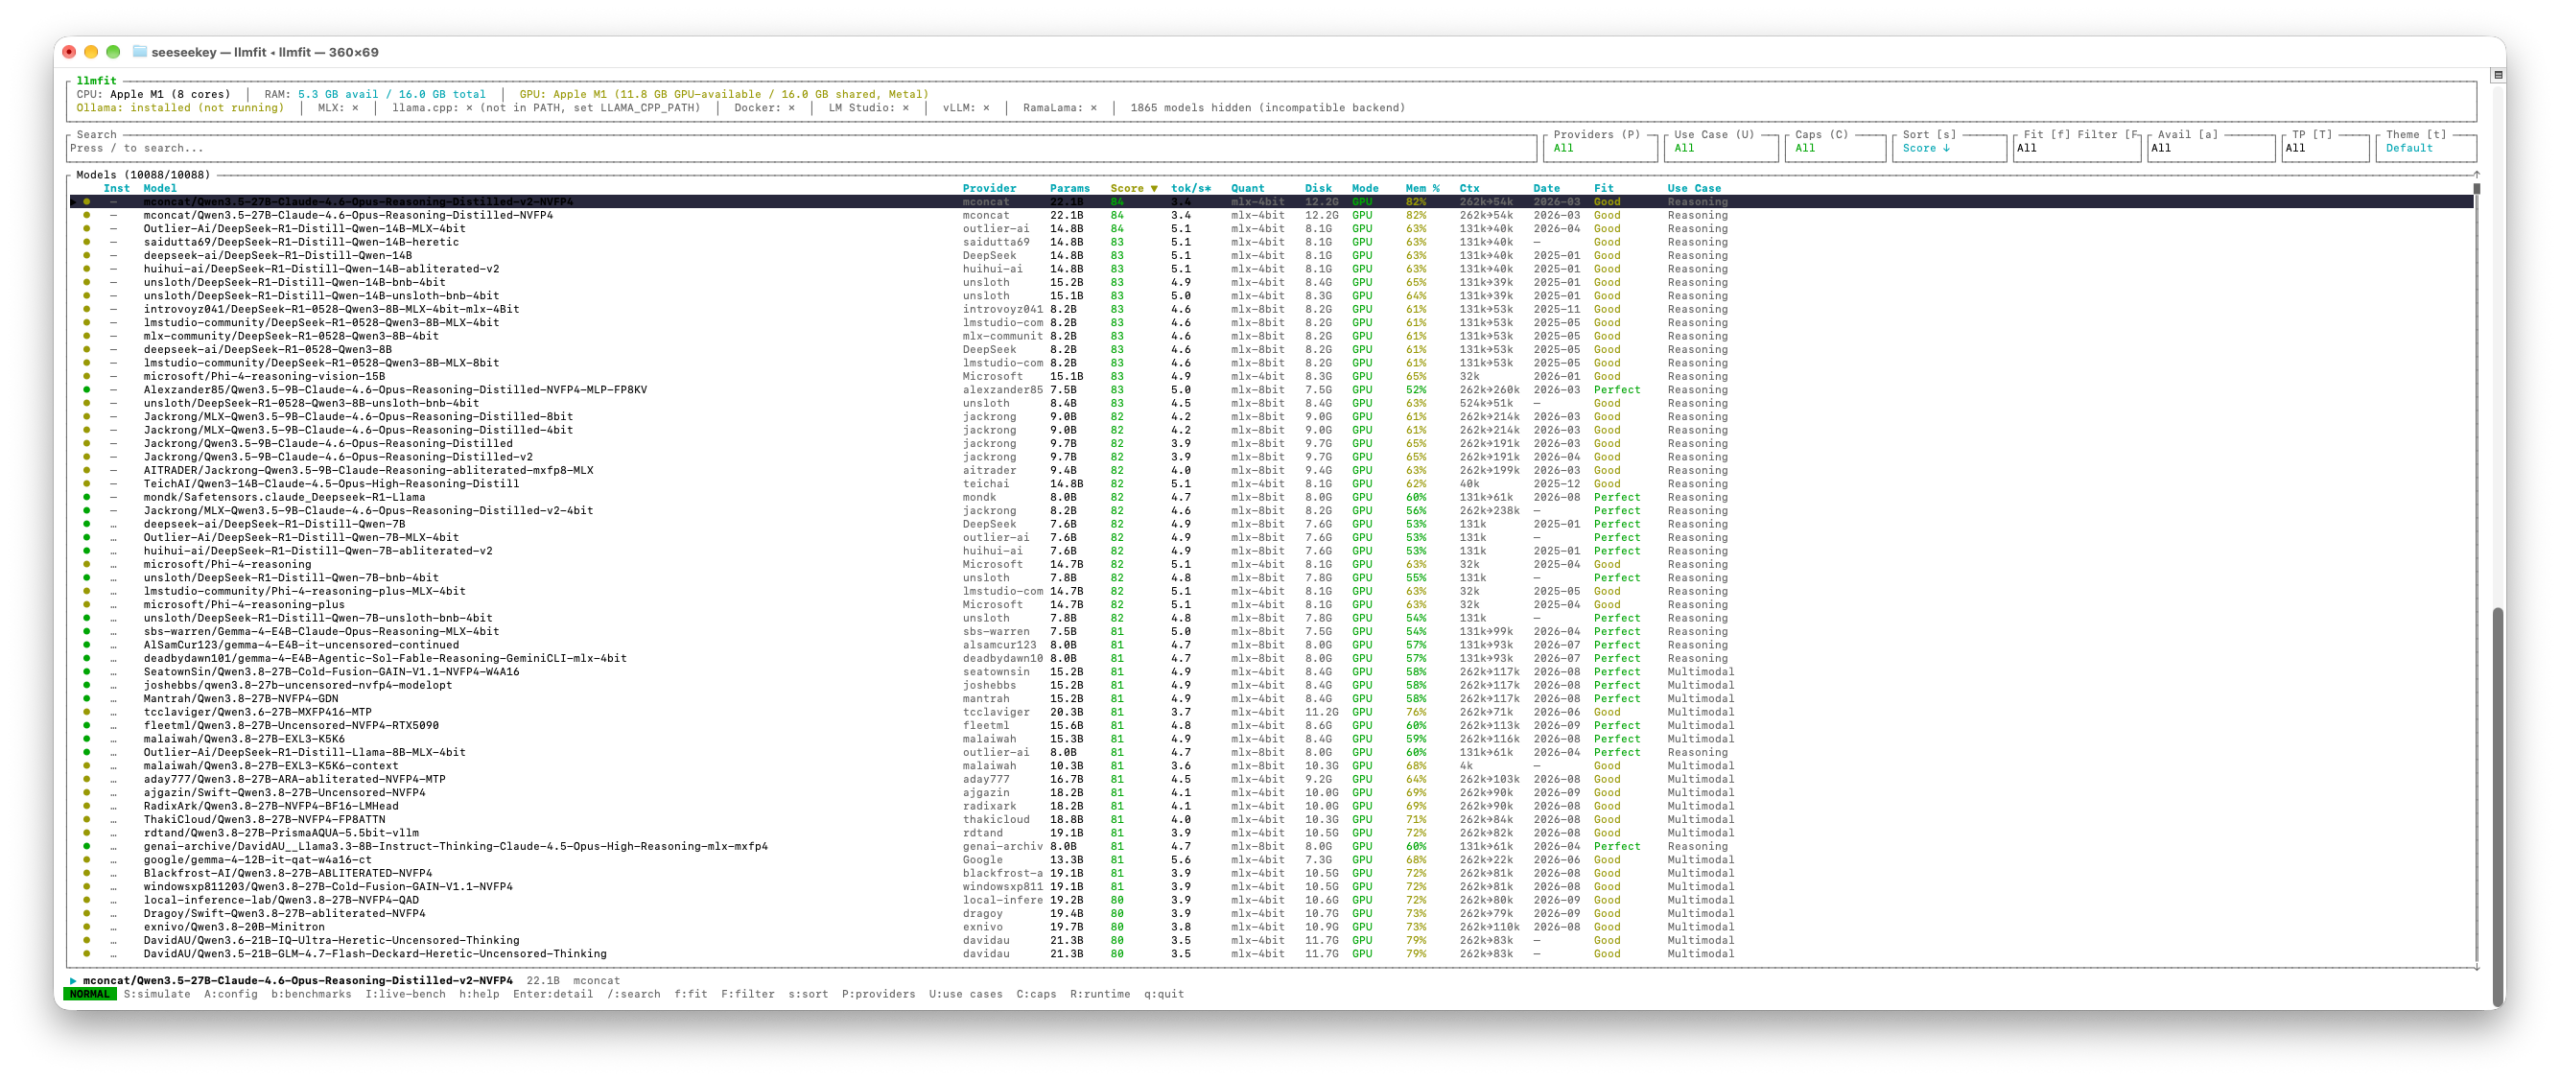
Die interaktive Oberfläche von llmfit

Dazu erkennt llmfit unter anderem den Prozessor, den Arbeitsspeicher sowie vorhandene Grafikkarten und deren Speicher. Auch der gemeinsam genutzte Speicher von Apple-Silicon-Systemen wird berücksichtigt. Auf dieser Grundlage bewertet das Werkzeug die Modelle aus seinem Katalog nach Speicherbedarf, geschätzter Geschwindigkeit, Qualität und Kontextgröße. Daneben wird eine passende Quantisierung ermittelt, bei welcher die Modellgewichte mit geringerer Genauigkeit gespeichert werden, um den Speicherbedarf zu reduzieren. Alternativ können auch andere Rechnerkonfigurationen hinterlegt werden.

Unter macOS kann llmfit über Homebrew installiert werden:

brew install llmfit

Nach der Installation kann das Werkzeug mittels:

llmfit

gestartet werden. Damit öffnet sich eine interaktive Oberfläche im Terminal. Im oberen Bereich werden die erkannten Hardwaredaten dargestellt. Darunter befindet sich eine Tabelle mit den bewerteten Modellen, einschließlich der geschätzten Geschwindigkeit in Tokens pro Sekunde und der empfohlenen Quantisierung. Für eine einfache tabellarische Ausgabe kann alternativ:

llmfit fit

genutzt werden. Empfehlungen lassen sich außerdem nach ihrem Einsatzzweck filtern. Wer beispielsweise ein Modell für die Softwareentwicklung sucht, kann die Ergebnisse als JSON ausgeben lassen:

llmfit recommend --json --use-case coding --limit 3

Die Geschwindigkeitsangaben sollten zunächst als Schätzungen verstanden werden. Für eine Messung über eine bereits laufende lokale Laufzeitumgebung, beispielsweise Ollama, steht das Subkommando:

llmfit bench

zur Verfügung. Damit kann die Einschätzung durch Messwerte auf dem eigenen Rechner ergänzt werden. Der Quelltext von llmfit ist auf GitHub zu finden. Lizenziert ist das Werkzeug unter der MIT-Lizenz und damit freie Software.

Homebrew-Pakete übertragen

Wer auf einem Mac viele Applikationen über Homebrew installiert hat und diese ebenfalls auf einem anderen Rechner installieren möchte, kann hierfür ebenfalls Homebrew nutzen:

brew bundle dump

Damit wird ein Brewfile angelegt. Dieses enthält die installierten Formulae und Casks. Auf einem neuen oder frisch installierten System können die Pakete anschließend mit:

brew bundle

wieder installiert werden. Damit lässt sich die Homebrew-Umgebung eines Macs mit wenig Aufwand reproduzieren.

Duplikate mit fdupes finden

Wer im Terminal unter macOS Duplikate finden möchte, kann hierfür auf fdupes zurückgreifen. Nach der Installation mittels:

brew install fdupes

kann das Werkzeug im geünschten Ordner genutzt werden:

fdupes -r .

In diesem Fall wird der aktuelle Ordner rekursiv nach Duplikaten durchsucht. Anschließend werden diese Duplikate dargestellt:

./FolderA/file-01.bin
./FolderB/file-01.bin

./FolderA/file-02.bin
./FolderB/file-02.bin

./FolderA/file-03.bin
./FolderB/file-03.bin

Bei dieser Operation werden keinerlei Dateien gelöscht. Dazu bietet fdupes unter anderem einen interaktiven Modus an:

fupes -r -d .

Nach der Ermittlung der Duplikate kann anschließend die Auswahl getroffen werden, welche Dateien nicht gelöscht werden sollen:

Set 17 of 108:

[ ] ./FolderA/file-17.bin
[ ] ./FolderB/file-17.bin

( Preserve files [1 - 2, all, help] )= 1

Ist der interaktive Modus nicht gewünscht, so kann die Löschung auch automatisiert werden. Das Kommando:

fdupes -r -d -N .

behält immer automatisch die erste Datei und löscht alle anderen Duplikate. Damit eignet sich fdupes besonders gut, um große Dateibestände schnell und effizient von doppelten Dateien zu bereinigen und dabei wahlweise die volle Kontrolle zu behalten oder den Vorgang vollständig zu automatisieren.

Endianness bei ROMs korrigieren

Einige ROMs wie z.B. vom Nintendo 64 sind als Big Endian gespeichert. Je nach Dump, kann es aber vorkommen das diese im Little Endian-Format gesichert wurde. Bei Big Endian wird das höchstwertige Byte zuerst gespeichert, während Little Endian mit dem niedrigstwertigen Byte beginnt. Soll die Bit-Reihenfolge umgedreht werden, so kann hierfür das Werkzeug uCON64 genutzt werden. Nach der Installation mittels Homebrew:

brew install ucon64

kann das Tool genutzt werden. Es kann dabei mit einer Vielzahl an ROM-Formaten umgehen. Mit diesem Skript können die Dateien in ihre Big Endian-Form konvertiert werden:

#!/bin/sh
find . -type f \( -iname "*.n64" -o -iname "*.v64" -o -iname "*.z64" \) -print0 |
while IFS= read -r -d '' f; do
  if ucon64 "$f" | grep -q "Interleaved/Swapped: Yes"; then
    ucon64 --nbak --swap "$f"
  fi
done

Auf diese Weise wird sichergestellt, dass alle ROMs im einheitlichen und historisch korrekteren Format vorliegen.

Speicher unter macOS bereinigen

Vor allem vor einem macOS-Update kann es vorkommen, dass auf den kleineren Speicherkonfigurationen eines Macs der Speicher knapp wird. Neben dem manuellen Ausmisten helfen hierbei auch Tools wie mac-cleanup-py. Das Tool kann über Homebrew installiert werden:

brew install mac-cleanup-py

Nach der Installation kann das Werkzeug über:

sudo mac-cleanup

aus dem Terminal heraus angestartet werden. Beim ersten Aufruf können die Module für die Bereinigung aktiviert werden. Später kann dies mittels:

mac-cleanup -c

wiederholt werden. Soll die Bereinigung ohne nachfragen durchgeführt werden kann der Parameter -f mit angehangen werden:

sudo mac-cleanup -f

Das Tool selbst ist freie Software unter der Apache License in Version 2.