Passende Sprachmodelle für die eigene Hardware finden

Wer Sprachmodelle lokal ausführen möchte, steht zunächst vor der Frage, welche Modelle auf der vorhandenen Hardware sinnvoll genutzt werden können. Neben der Größe des Modells spielen hierbei der verfügbare Speicher und die gewünschte Kontextgröße eine Rolle. Das Werkzeug llmfit hilft dabei, passende Modelle für den eigenen Rechner zu finden.
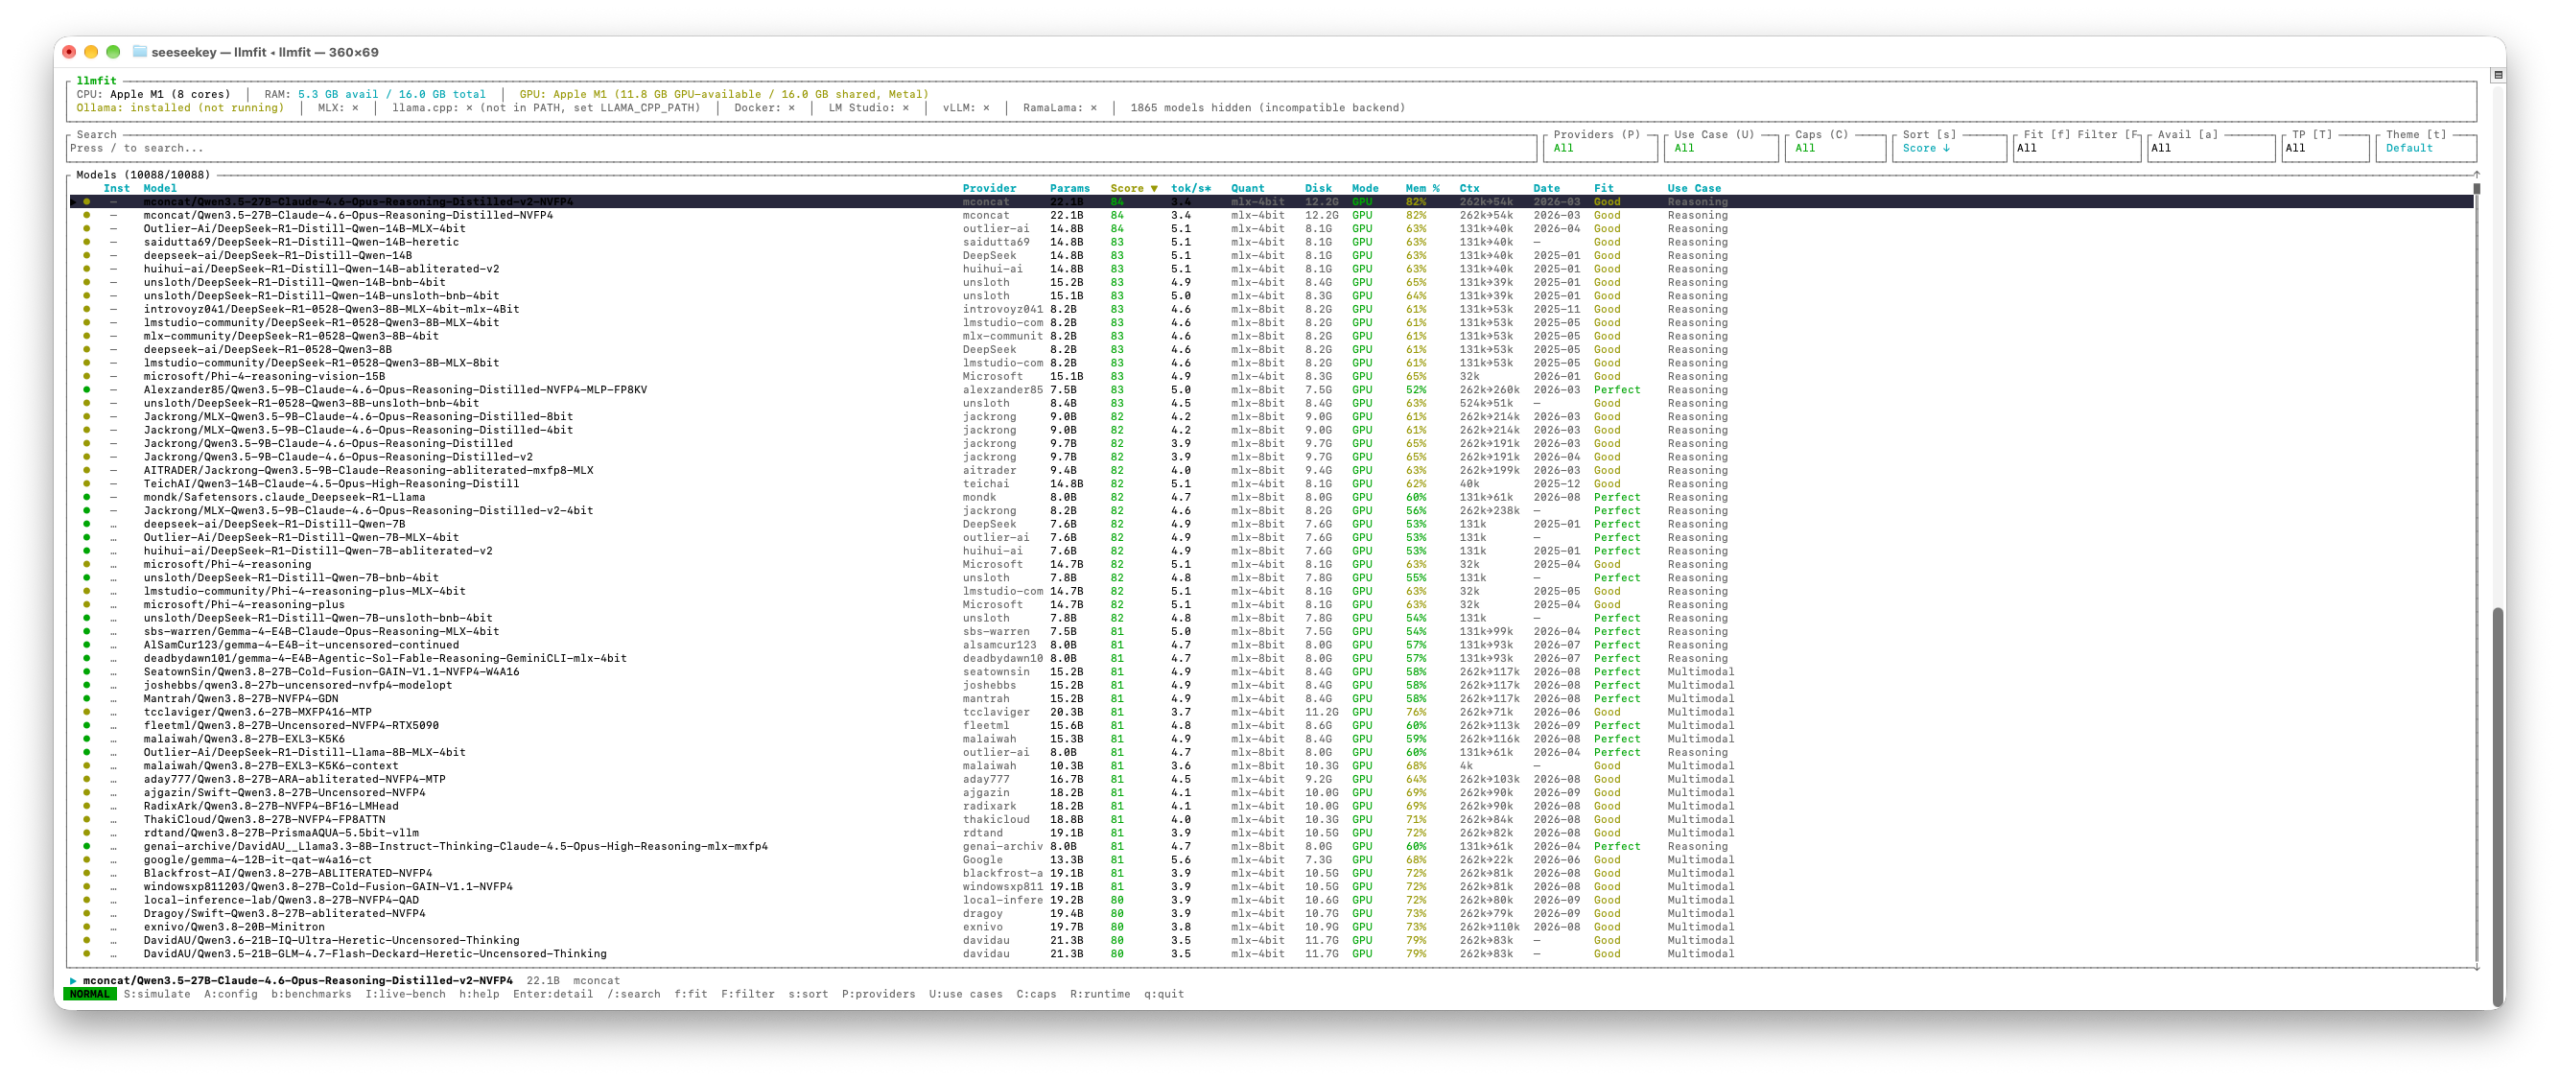
Die interaktive Oberfläche von llmfit

Dazu erkennt llmfit unter anderem den Prozessor, den Arbeitsspeicher sowie vorhandene Grafikkarten und deren Speicher. Auch der gemeinsam genutzte Speicher von Apple-Silicon-Systemen wird berücksichtigt. Auf dieser Grundlage bewertet das Werkzeug die Modelle aus seinem Katalog nach Speicherbedarf, geschätzter Geschwindigkeit, Qualität und Kontextgröße. Daneben wird eine passende Quantisierung ermittelt, bei welcher die Modellgewichte mit geringerer Genauigkeit gespeichert werden, um den Speicherbedarf zu reduzieren. Alternativ können auch andere Rechnerkonfigurationen hinterlegt werden.

Unter macOS kann llmfit über Homebrew installiert werden:

brew install llmfit

Nach der Installation kann das Werkzeug mittels:

llmfit

gestartet werden. Damit öffnet sich eine interaktive Oberfläche im Terminal. Im oberen Bereich werden die erkannten Hardwaredaten dargestellt. Darunter befindet sich eine Tabelle mit den bewerteten Modellen, einschließlich der geschätzten Geschwindigkeit in Tokens pro Sekunde und der empfohlenen Quantisierung. Für eine einfache tabellarische Ausgabe kann alternativ:

llmfit fit

genutzt werden. Empfehlungen lassen sich außerdem nach ihrem Einsatzzweck filtern. Wer beispielsweise ein Modell für die Softwareentwicklung sucht, kann die Ergebnisse als JSON ausgeben lassen:

llmfit recommend --json --use-case coding --limit 3

Die Geschwindigkeitsangaben sollten zunächst als Schätzungen verstanden werden. Für eine Messung über eine bereits laufende lokale Laufzeitumgebung, beispielsweise Ollama, steht das Subkommando:

llmfit bench

zur Verfügung. Damit kann die Einschätzung durch Messwerte auf dem eigenen Rechner ergänzt werden. Der Quelltext von llmfit ist auf GitHub zu finden. Lizenziert ist das Werkzeug unter der MIT-Lizenz und damit freie Software.
Fallout 1 und 2 unter macOS spielen

Die ersten beiden Fallout-Spiele lassen sich dank der Fallout Community Edition und der Fallout 2 Community Edition auch auf aktuellen Macs spielen. Dabei handelt es sich um Neuimplementierungen der ursprünglichen Spielengines, welche nativ auf Intel-Macs und Macs mit Apple Silicon laufen. Die Spieldaten der Originalspiele werden allerdings weiterhin benötigt.

Um die Einrichtung zu vereinfachen, habe ich zwei Installationsskripte geschrieben. Diese extrahieren die benötigten Daten aus den GOG-Offline-Installern, laden die aktuelle macOS-Version der jeweiligen Community Edition herunter und erstellen die passende Konfiguration. Anschließend wird das Spiel direkt gestartet.

Für Fallout 1 werden diese Dateien aus dem GOG-Offline-Installern erwartet:

setup_fallout_1.2_(27130).exe
setup_fallout_1.2_(27130)-1.bin

Für Fallout 2 sind es:

setup_fallout_2_1.02_gog_v1_(77792).exe
setup_fallout_2_1.02_gog_v1_(77792)-1.bin

Liegen die Skripte und Installationsdateien beispielsweise im Ordner Fallout innerhalb des Benutzerverzeichnisses, wird im Terminal zunächst in diesen gewechselt:

cd ~/Fallout
chmod +x install-fallout-1.sh install-fallout-2.sh

Anschließend kann Fallout 1 mit:

./install-fallout-1.sh

installiert werden. Für Fallout 2 lautet der entsprechende Aufruf:

./install-fallout-2.sh

Die Installation erfolgt unter /Applications/Fallout beziehungsweise /Applications/Fallout 2. Für diese Verzeichnisse und das Verzeichnis der Skripte müssen Schreibrechte vorhanden sein. Die Disk-Images der Community Editions werden automatisch heruntergeladen und eingebunden; ein manueller Download ist nicht notwendig.

Nach der Installation lassen sich die Spiele jederzeit über den Finder starten. Die Anwendungen heißen Fallout Community Edition.app und Fallout II Community Edition.app und befinden sich in den jeweiligen Installationsverzeichnissen. Die Installationsskripte stehen unter der MIT-Lizenz. Der Quelltext und die ausführliche Anleitung sind im GitHub-Repository zu finden.

Rosetta-Probleme unter macOS 27

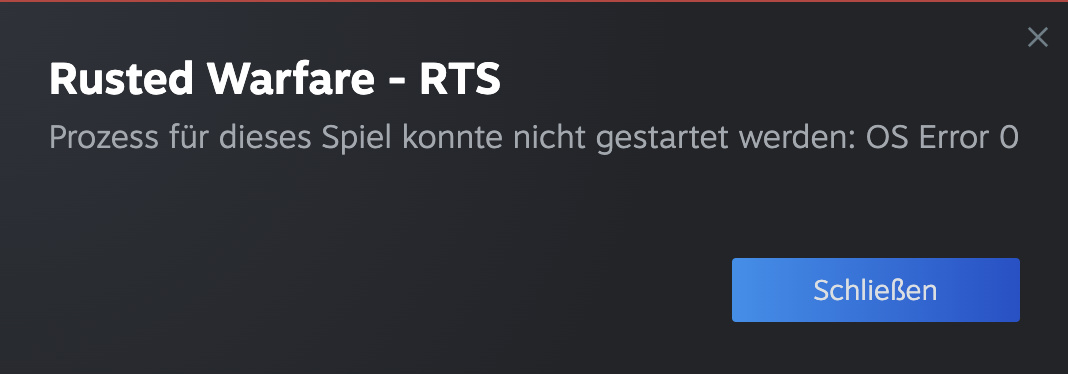
Mit dem Umstieg von Intel-Prozessoren auf Apple Silicon führte Apple im Jahr 2020 Rosetta 2 ein. Die Übersetzungsschicht ermöglicht es, für Intel-Prozessoren kompilierte Anwendungen auch auf Macs mit Apple Silicon auszuführen. Auch unter macOS 27 ist Rosetta noch vorhanden. Nach dem Update auf macOS 27 kann es allerdings passieren, dass eine zuvor funktionierende Intel-Anwendung plötzlich nicht mehr startet, so z. B. Spiele unter Steam.

Das Spiel lässt sich unter macOS nach einem Update nicht mehr starten

In einem solchen Fall kann es helfen, Rosetta erneut zu installieren. Dies ist über das Terminal möglich:

softwareupdate --install-rosetta --agree-to-license

Nach der erneuten Installation lassen sich die betroffenen Anwendungen meist wieder wie gewohnt starten. Interessant wird dies vor allem deshalb, weil Rosetta langsam seinem Ende entgegengeht. macOS 27 ist die letzte macOS-Version, in der Rosetta als allgemeine Kompatibilitätsschicht für Intel-Anwendungen zur Verfügung steht. Ab macOS 28 sollen gewöhnliche Intel-Anwendungen nicht mehr über Rosetta ausgeführt werden können.

Ganz verschwinden wird die Technik allerdings zunächst nicht. Apple möchte einen Teil der Rosetta-Funktionalität für ältere, nicht mehr gepflegte Spiele erhalten. Apple spricht allerdings ausdrücklich nur von einem Teil der Rosetta-Funktionalität für solche Spiele. Daraus lässt sich nicht ableiten, dass jedes derzeit über Rosetta laufende Spiel auch unter macOS 28 weiterhin funktionieren wird.

Duplikate mit fdupes finden

Wer im Terminal unter macOS Duplikate finden möchte, kann hierfür auf fdupes zurückgreifen. Nach der Installation mittels:

brew install fdupes

kann das Werkzeug im geünschten Ordner genutzt werden:

fdupes -r .

In diesem Fall wird der aktuelle Ordner rekursiv nach Duplikaten durchsucht. Anschließend werden diese Duplikate dargestellt:

./FolderA/file-01.bin
./FolderB/file-01.bin

./FolderA/file-02.bin
./FolderB/file-02.bin

./FolderA/file-03.bin
./FolderB/file-03.bin

Bei dieser Operation werden keinerlei Dateien gelöscht. Dazu bietet fdupes unter anderem einen interaktiven Modus an:

fupes -r -d .

Nach der Ermittlung der Duplikate kann anschließend die Auswahl getroffen werden, welche Dateien nicht gelöscht werden sollen:

Set 17 of 108:

[ ] ./FolderA/file-17.bin
[ ] ./FolderB/file-17.bin

( Preserve files [1 - 2, all, help] )= 1

Ist der interaktive Modus nicht gewünscht, so kann die Löschung auch automatisiert werden. Das Kommando:

fdupes -r -d -N .

behält immer automatisch die erste Datei und löscht alle anderen Duplikate. Damit eignet sich fdupes besonders gut, um große Dateibestände schnell und effizient von doppelten Dateien zu bereinigen und dabei wahlweise die volle Kontrolle zu behalten oder den Vorgang vollständig zu automatisieren.

SSH-Schlüssel auf einer Storage Box von Hetzner installieren

Die Storage Boxen von Hetzner werden unter anderem gerne für Backups von Servern genutzt. Damit ein solchen mit entsprechenden Werkzeugen wie Restic erstellt werden können, ist meist ein SSH-Zugang vonnöten. Um den öffentlichen Schlüssel des Servers auf die Storage Box zu übertragen, kann folgender Befehl genutzt werden:

cat ~/.ssh/id_ed25519.pub  | ssh -p23  install-ssh-key

Nach der Abfrage des Passwortes für die Storage Box wird der Schlüssel übertragen und damit automatisch beim Aufbau einer SSH-Verbindung genutzt.