Minecraft-Skins und 3D-Modelle erstellen

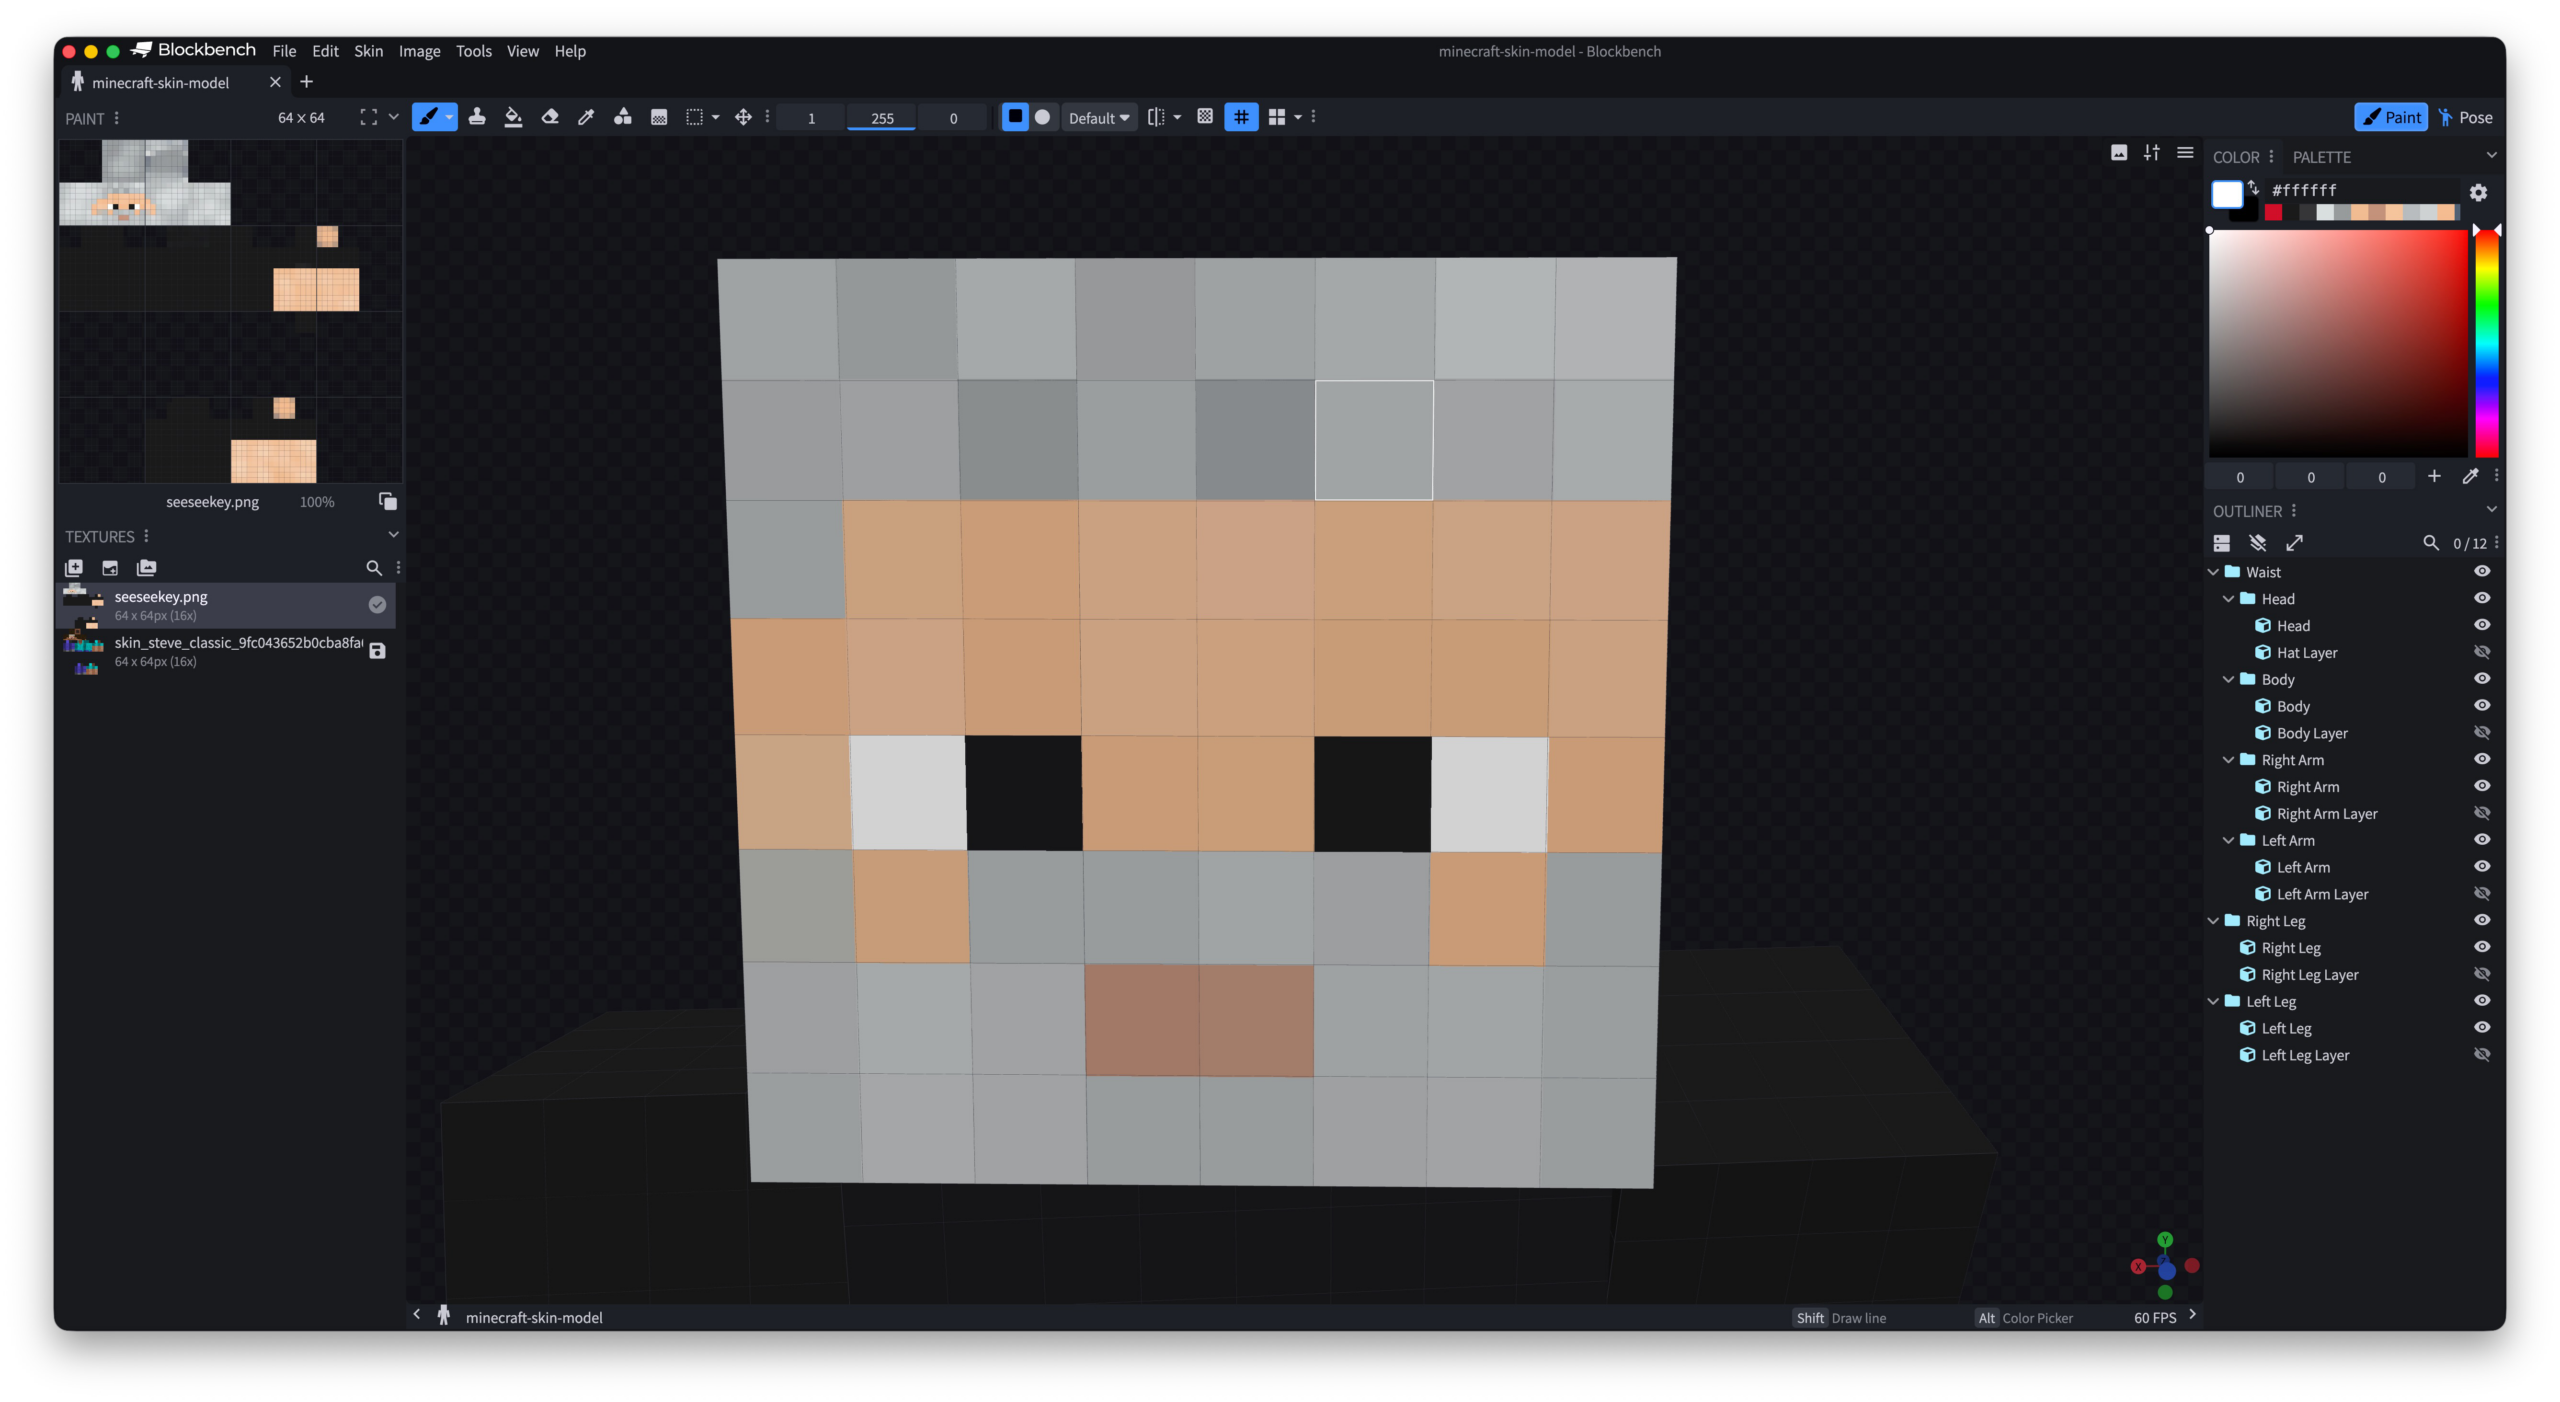
Da ich einen eigenen Minecraft-Skin erstellen wollte, war ich auf der Suche nach einem passenden Editor. Dabei bin ich auf Blockbench gestoßen. Hierbei handelt es sich um einen Editor für Low-Poly-Modelle, also 3D-Modelle mit einer vergleichsweise geringen Anzahl an Polygonen. Neben der Modellierung bietet die Anwendung Werkzeuge zum Zeichnen von Texturen und zum Erstellen von Animationen.

Blockbench unter macOS

Für Minecraft-Skins verfügt Blockbench über einen eigenen Bearbeitungsmodus. Unterstützt werden sowohl das klassische Spielermodell mit breiten Armen als auch die Variante mit schmalen Armen. Zwischen den beiden Varianten kann der Editor ebenfalls konvertieren. Praktisch ist hierbei, dass direkt auf dem dreidimensionalen Modell gezeichnet werden kann. Alternativ lässt sich die flache Textur in der 2D-Ansicht bearbeiten. So ist unmittelbar sichtbar, an welcher Stelle der Figur die einzelnen Pixel landen. Besonders bei Übergängen zwischen den Seiten eines Körpers erleichtert dies die Arbeit gegenüber der ausschließlichen Bearbeitung in einem gewöhnlichen Bildeditor.

Über die Skin-Bearbeitung hinaus können mit Blockbench unter anderem Modelle für die Java- und Bedrock-Edition von Minecraft erstellt werden. Auch allgemeine Low-Poly-Modelle lassen sich bearbeiten. Ein integrierter Animationseditor und ein Plugin-System ergänzen den Funktionsumfang. Die Anwendung steht für macOS, Linux und Windows zur Verfügung. Daneben existiert eine Web-Version, welche direkt im Browser genutzt werden kann.

Blockbench ist freie Software und unter der GPL in Version 3 lizenziert. Der Quellcode ist auf GitHub zu finden.

Passende Sprachmodelle für die eigene Hardware finden

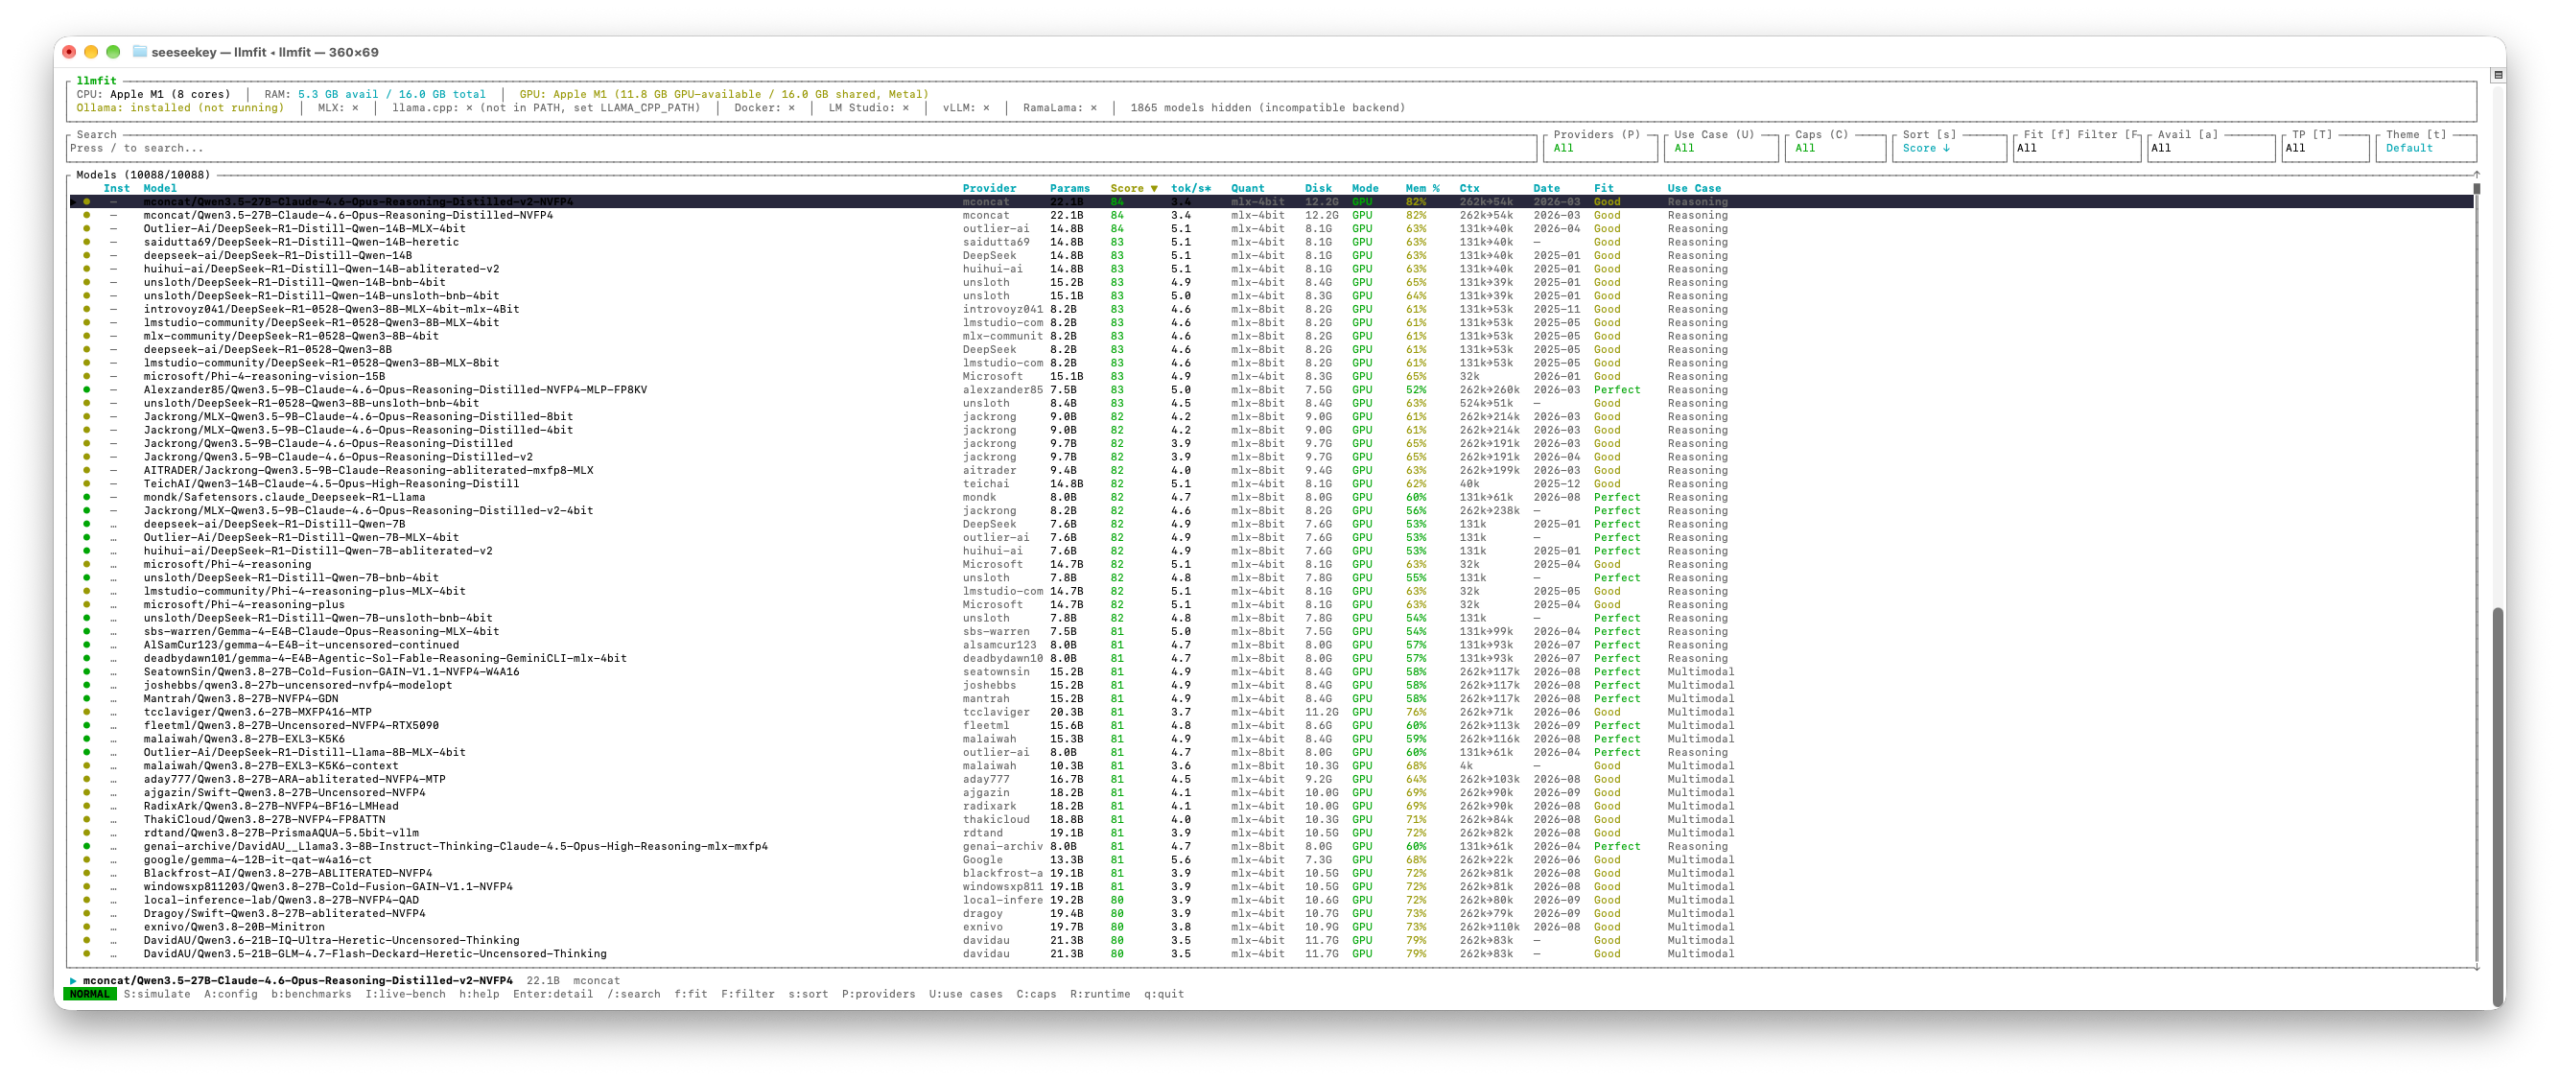
Wer Sprachmodelle lokal ausführen möchte, steht zunächst vor der Frage, welche Modelle auf der vorhandenen Hardware sinnvoll genutzt werden können. Neben der Größe des Modells spielen hierbei der verfügbare Speicher und die gewünschte Kontextgröße eine Rolle. Das Werkzeug llmfit hilft dabei, passende Modelle für den eigenen Rechner zu finden.

Die interaktive Oberfläche von llmfit

Dazu erkennt llmfit unter anderem den Prozessor, den Arbeitsspeicher sowie vorhandene Grafikkarten und deren Speicher. Auch der gemeinsam genutzte Speicher von Apple-Silicon-Systemen wird berücksichtigt. Auf dieser Grundlage bewertet das Werkzeug die Modelle aus seinem Katalog nach Speicherbedarf, geschätzter Geschwindigkeit, Qualität und Kontextgröße. Daneben wird eine passende Quantisierung ermittelt, bei welcher die Modellgewichte mit geringerer Genauigkeit gespeichert werden, um den Speicherbedarf zu reduzieren. Alternativ können auch andere Rechnerkonfigurationen hinterlegt werden.

Unter macOS kann llmfit über Homebrew installiert werden:

brew install llmfit

Nach der Installation kann das Werkzeug mittels:

llmfit

gestartet werden. Damit öffnet sich eine interaktive Oberfläche im Terminal. Im oberen Bereich werden die erkannten Hardwaredaten dargestellt. Darunter befindet sich eine Tabelle mit den bewerteten Modellen, einschließlich der geschätzten Geschwindigkeit in Tokens pro Sekunde und der empfohlenen Quantisierung. Für eine einfache tabellarische Ausgabe kann alternativ:

llmfit fit

genutzt werden. Empfehlungen lassen sich außerdem nach ihrem Einsatzzweck filtern. Wer beispielsweise ein Modell für die Softwareentwicklung sucht, kann die Ergebnisse als JSON ausgeben lassen:

llmfit recommend --json --use-case coding --limit 3

Die Geschwindigkeitsangaben sollten zunächst als Schätzungen verstanden werden. Für eine Messung über eine bereits laufende lokale Laufzeitumgebung, beispielsweise Ollama, steht das Subkommando:

llmfit bench

zur Verfügung. Damit kann die Einschätzung durch Messwerte auf dem eigenen Rechner ergänzt werden. Der Quelltext von llmfit ist auf GitHub zu finden. Lizenziert ist das Werkzeug unter der MIT-Lizenz und damit freie Software.

Fallout 1 und 2 unter macOS spielen

Die ersten beiden Fallout-Spiele lassen sich dank der Fallout Community Edition und der Fallout 2 Community Edition auch auf aktuellen Macs spielen. Dabei handelt es sich um Neuimplementierungen der ursprünglichen Spielengines, welche nativ auf Intel-Macs und Macs mit Apple Silicon laufen. Die Spieldaten der Originalspiele werden allerdings weiterhin benötigt.

Um die Einrichtung zu vereinfachen, habe ich zwei Installationsskripte geschrieben. Diese extrahieren die benötigten Daten aus den GOG-Offline-Installern, laden die aktuelle macOS-Version der jeweiligen Community Edition herunter und erstellen die passende Konfiguration. Anschließend wird das Spiel direkt gestartet.

Für Fallout 1 werden diese Dateien aus dem GOG-Offline-Installern erwartet:

setup_fallout_1.2_(27130).exe
setup_fallout_1.2_(27130)-1.bin

Für Fallout 2 sind es:

setup_fallout_2_1.02_gog_v1_(77792).exe
setup_fallout_2_1.02_gog_v1_(77792)-1.bin

Liegen die Skripte und Installationsdateien beispielsweise im Ordner Fallout innerhalb des Benutzerverzeichnisses, wird im Terminal zunächst in diesen gewechselt:

cd ~/Fallout
chmod +x install-fallout-1.sh install-fallout-2.sh

Anschließend kann Fallout 1 mit:

./install-fallout-1.sh

installiert werden. Für Fallout 2 lautet der entsprechende Aufruf:

./install-fallout-2.sh

Die Installation erfolgt unter /Applications/Fallout beziehungsweise /Applications/Fallout 2. Für diese Verzeichnisse und das Verzeichnis der Skripte müssen Schreibrechte vorhanden sein. Die Disk-Images der Community Editions werden automatisch heruntergeladen und eingebunden; ein manueller Download ist nicht notwendig.

Nach der Installation lassen sich die Spiele jederzeit über den Finder starten. Die Anwendungen heißen Fallout Community Edition.app und Fallout II Community Edition.app und befinden sich in den jeweiligen Installationsverzeichnissen. Die Installationsskripte stehen unter der MIT-Lizenz. Der Quelltext und die ausführliche Anleitung sind im GitHub-Repository zu finden.

Tool-Aufrufe unter OpenCode reparieren

Der Open-Source AI-Coding-Agent OpenCode lässt sich nicht nur mit den üblichen Cloud-Anbietern, sondern auch mit lokalen bzw. selbst gehosteten Sprachmodellen nutzen. Dazu kann beispielsweise Ollama über dessen OpenAI-kompatible API angebunden werden.
OpenCode Desktop unter macOS

In Verbindung mit bestimmten Modellen wie dem qwen3-coder:30b zeigte sich allerdings ein interessantes Problem. Tool-Aufrufe funktionieren nicht, da sie oft als Klartext ausgeben und nicht korrekt interpretiert werden. Probleme mit Tool-Aufrufen sind im OpenCode-Projekt bereits länger bekannt und diskutiert.

Ob das verwendete Modell grundsätzlich Tool-Aufrufe unterstützt, lässt sich mit:

ollama show qwen3-coder:30b

überprüfen. Unter Capabilities sollte hierbei unter anderem:

tools

aufgeführt sein. Ist dies der Fall und funktionieren die Werkzeuge in OpenCode trotzdem nicht zuverlässig, kann die Ursache im von Ollama verwendeten Kontextfenster liegen.

OpenCode benötigt für agentisches Arbeiten vergleichsweise viel Kontext. Neben der eigentlichen Unterhaltung befinden sich dort unter anderem der System-Prompt und die Beschreibungen der zur Verfügung stehenden Werkzeuge. Ist das Kontextfenster zu klein, können Tool-Aufrufe dadurch nicht mehr zuverlässig funktionieren. Auch die OpenCode-Dokumentation weist bei Problemen mit Tool Calls in Verbindung mit Ollama darauf hin, num_ctx zu erhöhen.

Wird Ollama allerdings über die OpenAI-kompatible Schnittstelle von OpenCode angesprochen, lässt sich num_ctx nicht ohne Weiteres zuverlässig über die OpenCode-Konfiguration setzen. Als Workaround kann deshalb ein eigenes Ollama-Modell mit fest eingestellter Kontextgröße angelegt werden. Dazu wird das gewünschte Modell zunächst gestartet:

ollama run qwen3-coder:30b

Anschließend wird die Kontextgröße gesetzt:

/set parameter num_ctx 131072

und die Konfiguration unter einem neuen Modellnamen gespeichert:

/save qwen3-coder:30b-128k
/bye

Damit existiert neben dem ursprünglichen Modell nun eine Variante, bei welcher das größere Kontextfenster fest hinterlegt ist. Die Größe muss nicht zwangsläufig 128K betragen. Für Tool-Aufrufe empfiehlt OpenCode eine Erhöhung in den Bereich von 16K bis 32K. Bei entsprechend verfügbarem Speicher kann für längere Coding-Sitzungen allerdings auch ein deutlich größeres Kontextfenster sinnvoll sein. In OpenCode muss anschließend das neu angelegte Modell konfiguriert werden:

nano ~/.config/opencode/opencode.json

Eine entsprechende Konfiguration kann beispielsweise wie folgt aussehen:

{
  "$schema": "https://opencode.ai/config.json",

  "provider": {
    "remote-ollama": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Remote Ollama",

      "options": {
        "baseURL": "https://example.org/ollama/v1",

        "headers": {
          "Authorization": "Bearer secret-token-123"
        }
      },

      "models": {
        "qwen3-coder:30b-128k": {
          "name": "Qwen3 Coder 30B 128K",
          "tools": true,
          "limit": {
            "context": 131072,
            "output": 16384
          }
        }
      }
    }
  },

  "model": "remote-ollama/qwen3-coder:30b-128k"
}

Wichtig ist hierbei die Unterscheidung zwischen den beiden Konfigurationen. Mit:

"limit": {
  "context": 131072,
  "output": 16384
}

wird OpenCode mitgeteilt, welche Grenzen das Modell besitzt. Dadurch wird allerdings nicht die tatsächliche Kontextgröße gesetzt, diese wurde stattdessen im neuen Modell angelegt. Nach einem Neustart von OpenCode kann das Tooling beispielsweise mit:

Erstelle eine Datei todo.md mit exakt dem Inhalt ‚hello world‘.

getestet werden. Wird die Datei tatsächlich über die OpenCode-Werkzeuge angelegt, funktionieren die Tool-Aufrufe. Da sich OpenCode und die Anbindung lokaler Modelle derzeit schnell weiterentwickeln, kann es allerdings auch mit dieser Konfiguration zu Problemen mit Tool-Aufrufen kommen, die andere Ursachen haben.
Rosetta-Probleme unter macOS 27

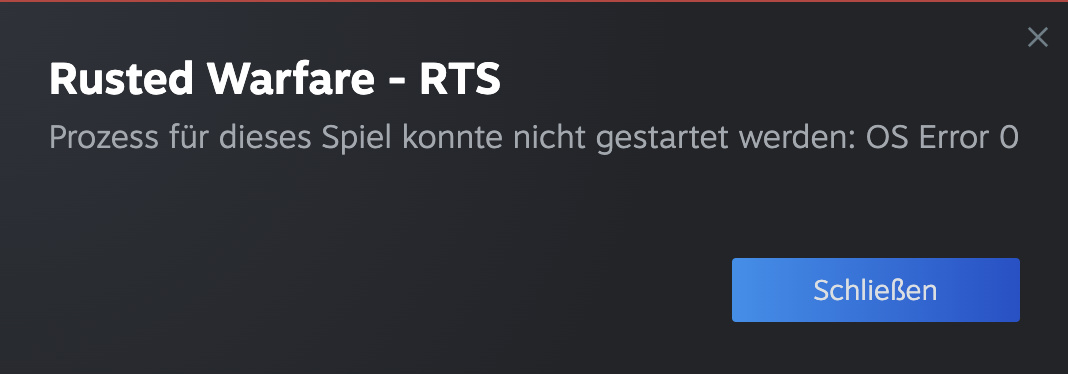
Mit dem Umstieg von Intel-Prozessoren auf Apple Silicon führte Apple im Jahr 2020 Rosetta 2 ein. Die Übersetzungsschicht ermöglicht es, für Intel-Prozessoren kompilierte Anwendungen auch auf Macs mit Apple Silicon auszuführen. Auch unter macOS 27 ist Rosetta noch vorhanden. Nach dem Update auf macOS 27 kann es allerdings passieren, dass eine zuvor funktionierende Intel-Anwendung plötzlich nicht mehr startet, so z. B. Spiele unter Steam.

Das Spiel lässt sich unter macOS nach einem Update nicht mehr starten

In einem solchen Fall kann es helfen, Rosetta erneut zu installieren. Dies ist über das Terminal möglich:

softwareupdate --install-rosetta --agree-to-license

Nach der erneuten Installation lassen sich die betroffenen Anwendungen meist wieder wie gewohnt starten. Interessant wird dies vor allem deshalb, weil Rosetta langsam seinem Ende entgegengeht. macOS 27 ist die letzte macOS-Version, in der Rosetta als allgemeine Kompatibilitätsschicht für Intel-Anwendungen zur Verfügung steht. Ab macOS 28 sollen gewöhnliche Intel-Anwendungen nicht mehr über Rosetta ausgeführt werden können.

Ganz verschwinden wird die Technik allerdings zunächst nicht. Apple möchte einen Teil der Rosetta-Funktionalität für ältere, nicht mehr gepflegte Spiele erhalten. Apple spricht allerdings ausdrücklich nur von einem Teil der Rosetta-Funktionalität für solche Spiele. Daraus lässt sich nicht ableiten, dass jedes derzeit über Rosetta laufende Spiel auch unter macOS 28 weiterhin funktionieren wird.