M5Stack

In den letzten Wochen beschäftigte ich mich mit unterschiedlichen Mikrocontrollern und Geräten auf Basis des ESP32. Dabei stieß ich auf die Produkte des chinesischen Herstellers M5Stack.
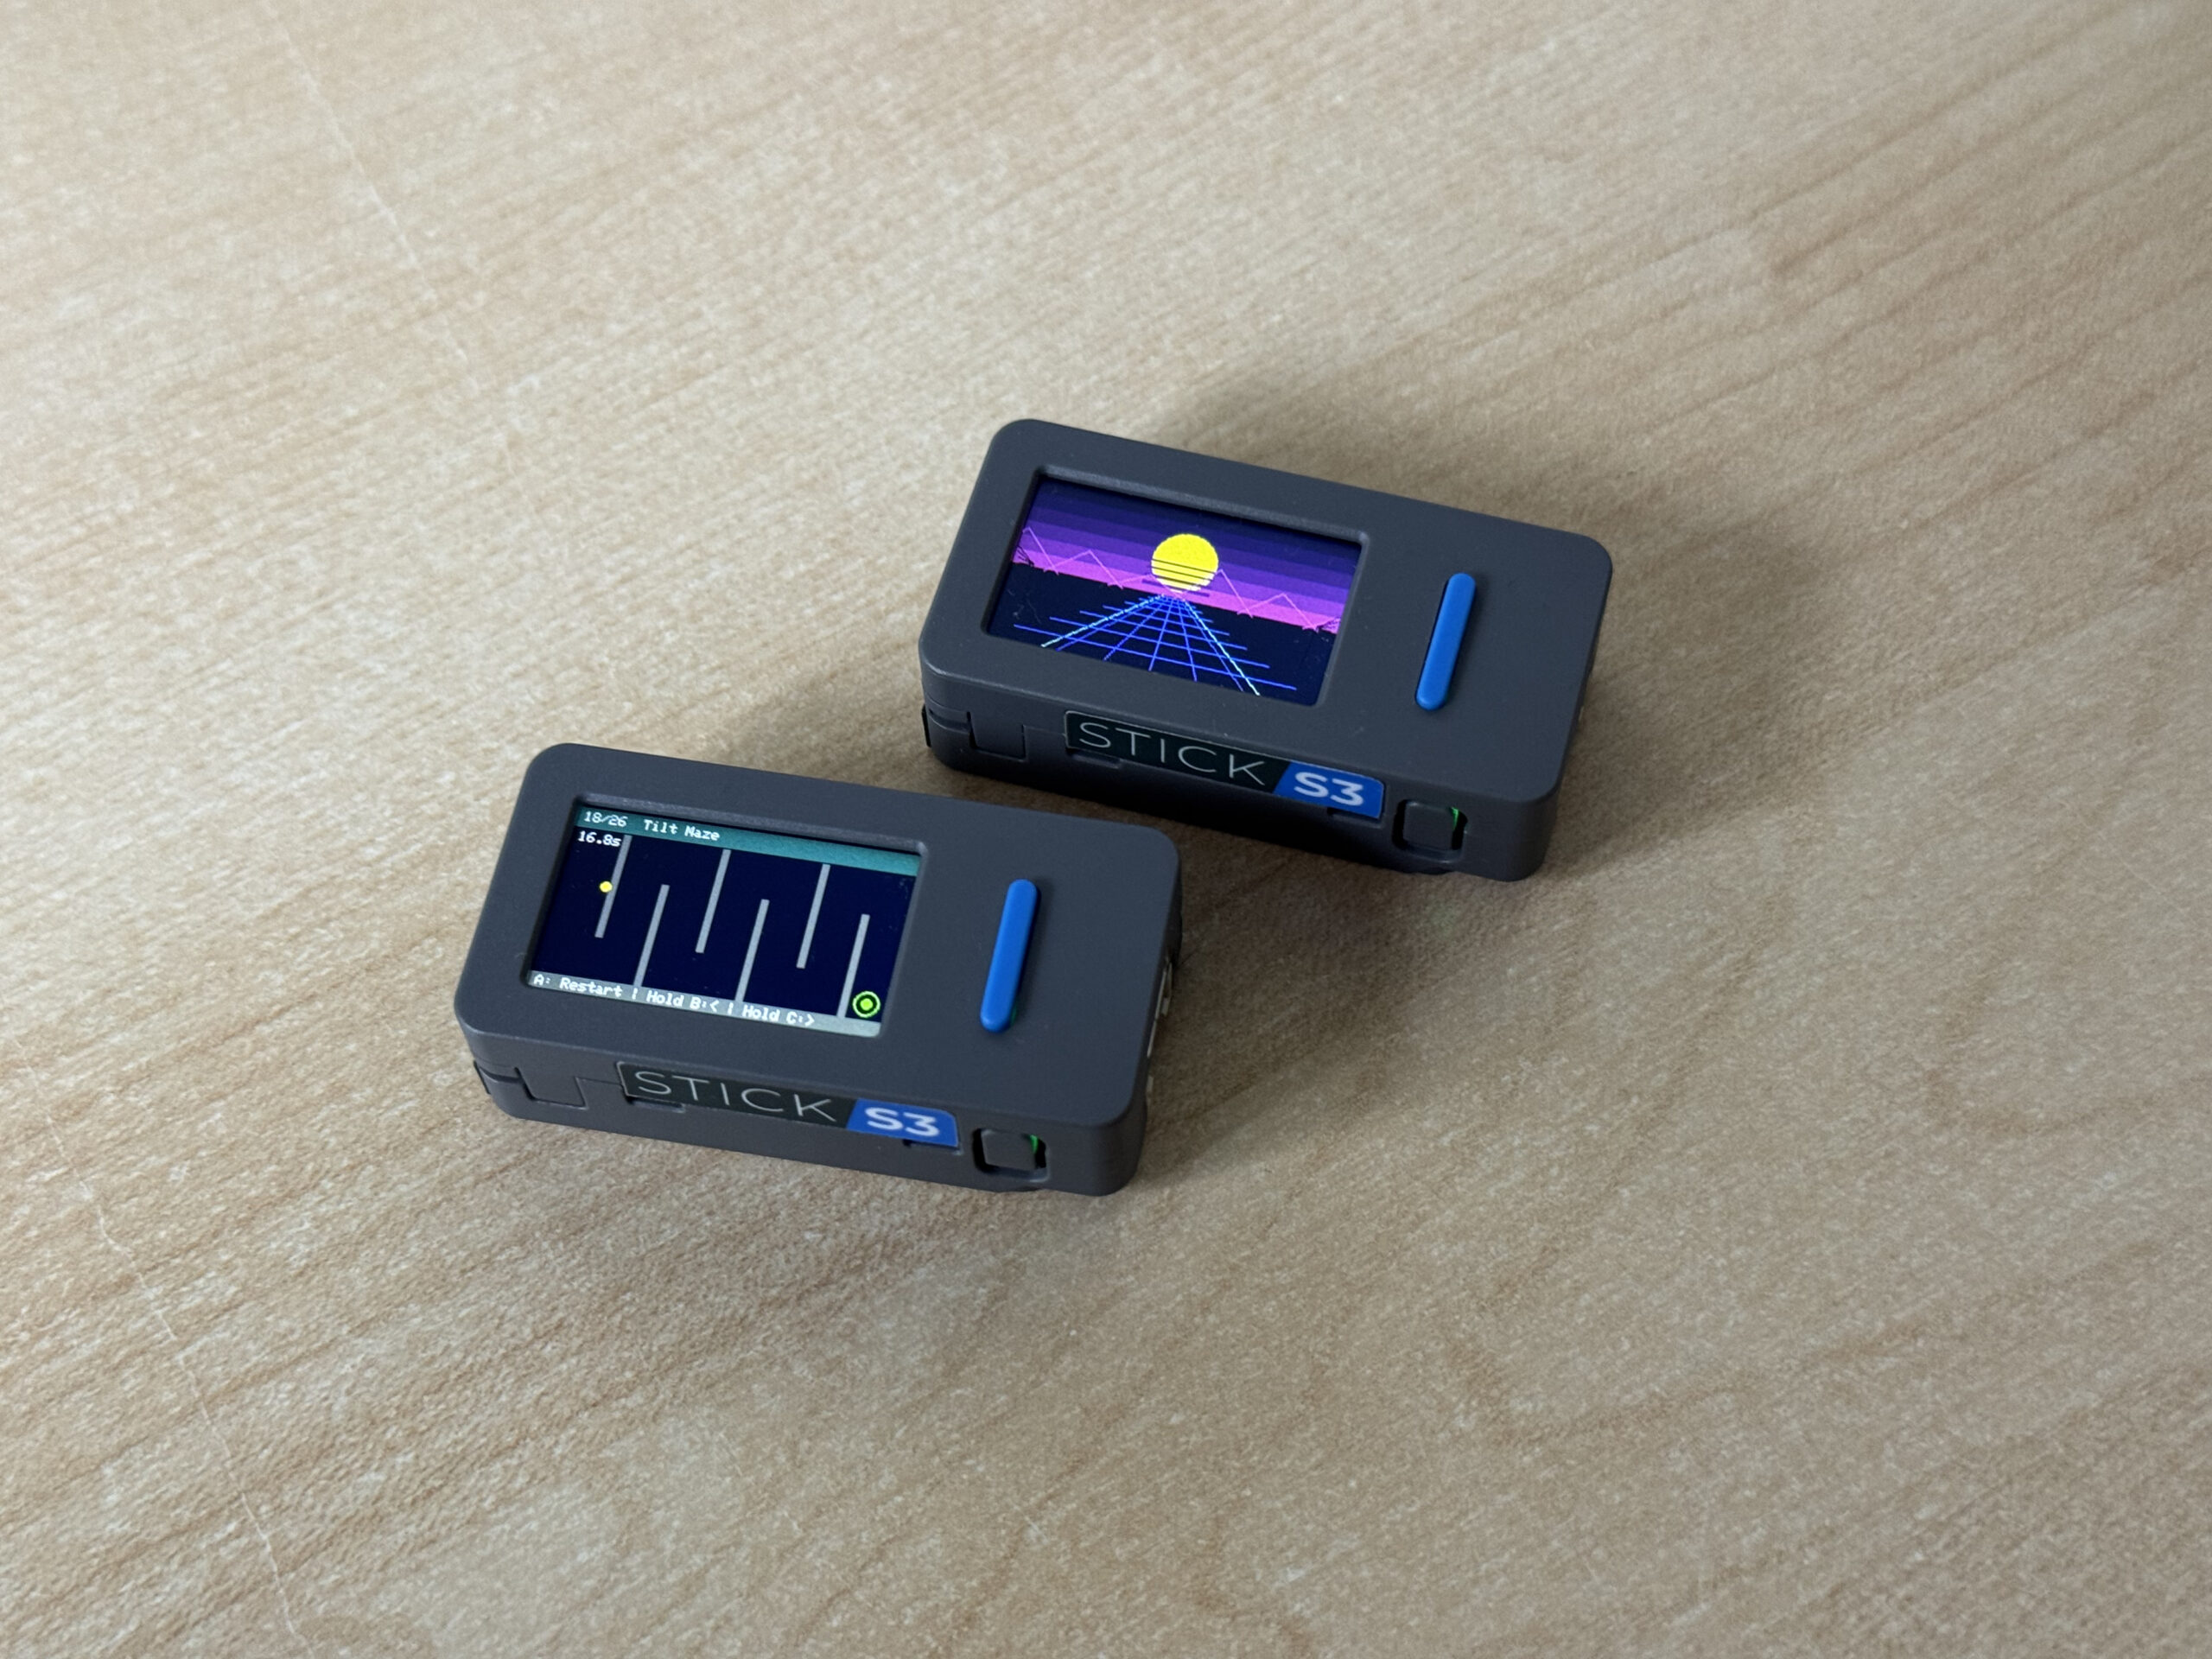
Die Stick S3 von M5Stack

Bei M5Stack handelt es sich nicht nur um einen Hersteller einzelner Entwicklungsboards, sondern um ein relativ umfangreiches Ökosystem. Angeboten werden unterschiedliche Mikrocontroller, Displays, Sensoren und Erweiterungsmodule. Interessant sind hierbei vor allem die Geräte, welche bereits mit Display, Gehäuse, Tasten und je nach Modell einem Akku ausgestattet sind.

Interessant ist das System vor allem dann, wenn nicht die Entwicklung der Hardware selbst im Vordergrund steht. Für ein klassisches Mikrocontrollerprojekt müssen neben dem Mikrocontroller meist Display, Stromversorgung und Bedienelemente ausgewählt und miteinander verbunden werden. Hier kann hingegen gleich mit fertiger Hardware gestartet werden, welche trotzdem über entsprechende Schnittstellen erweitert werden kann.
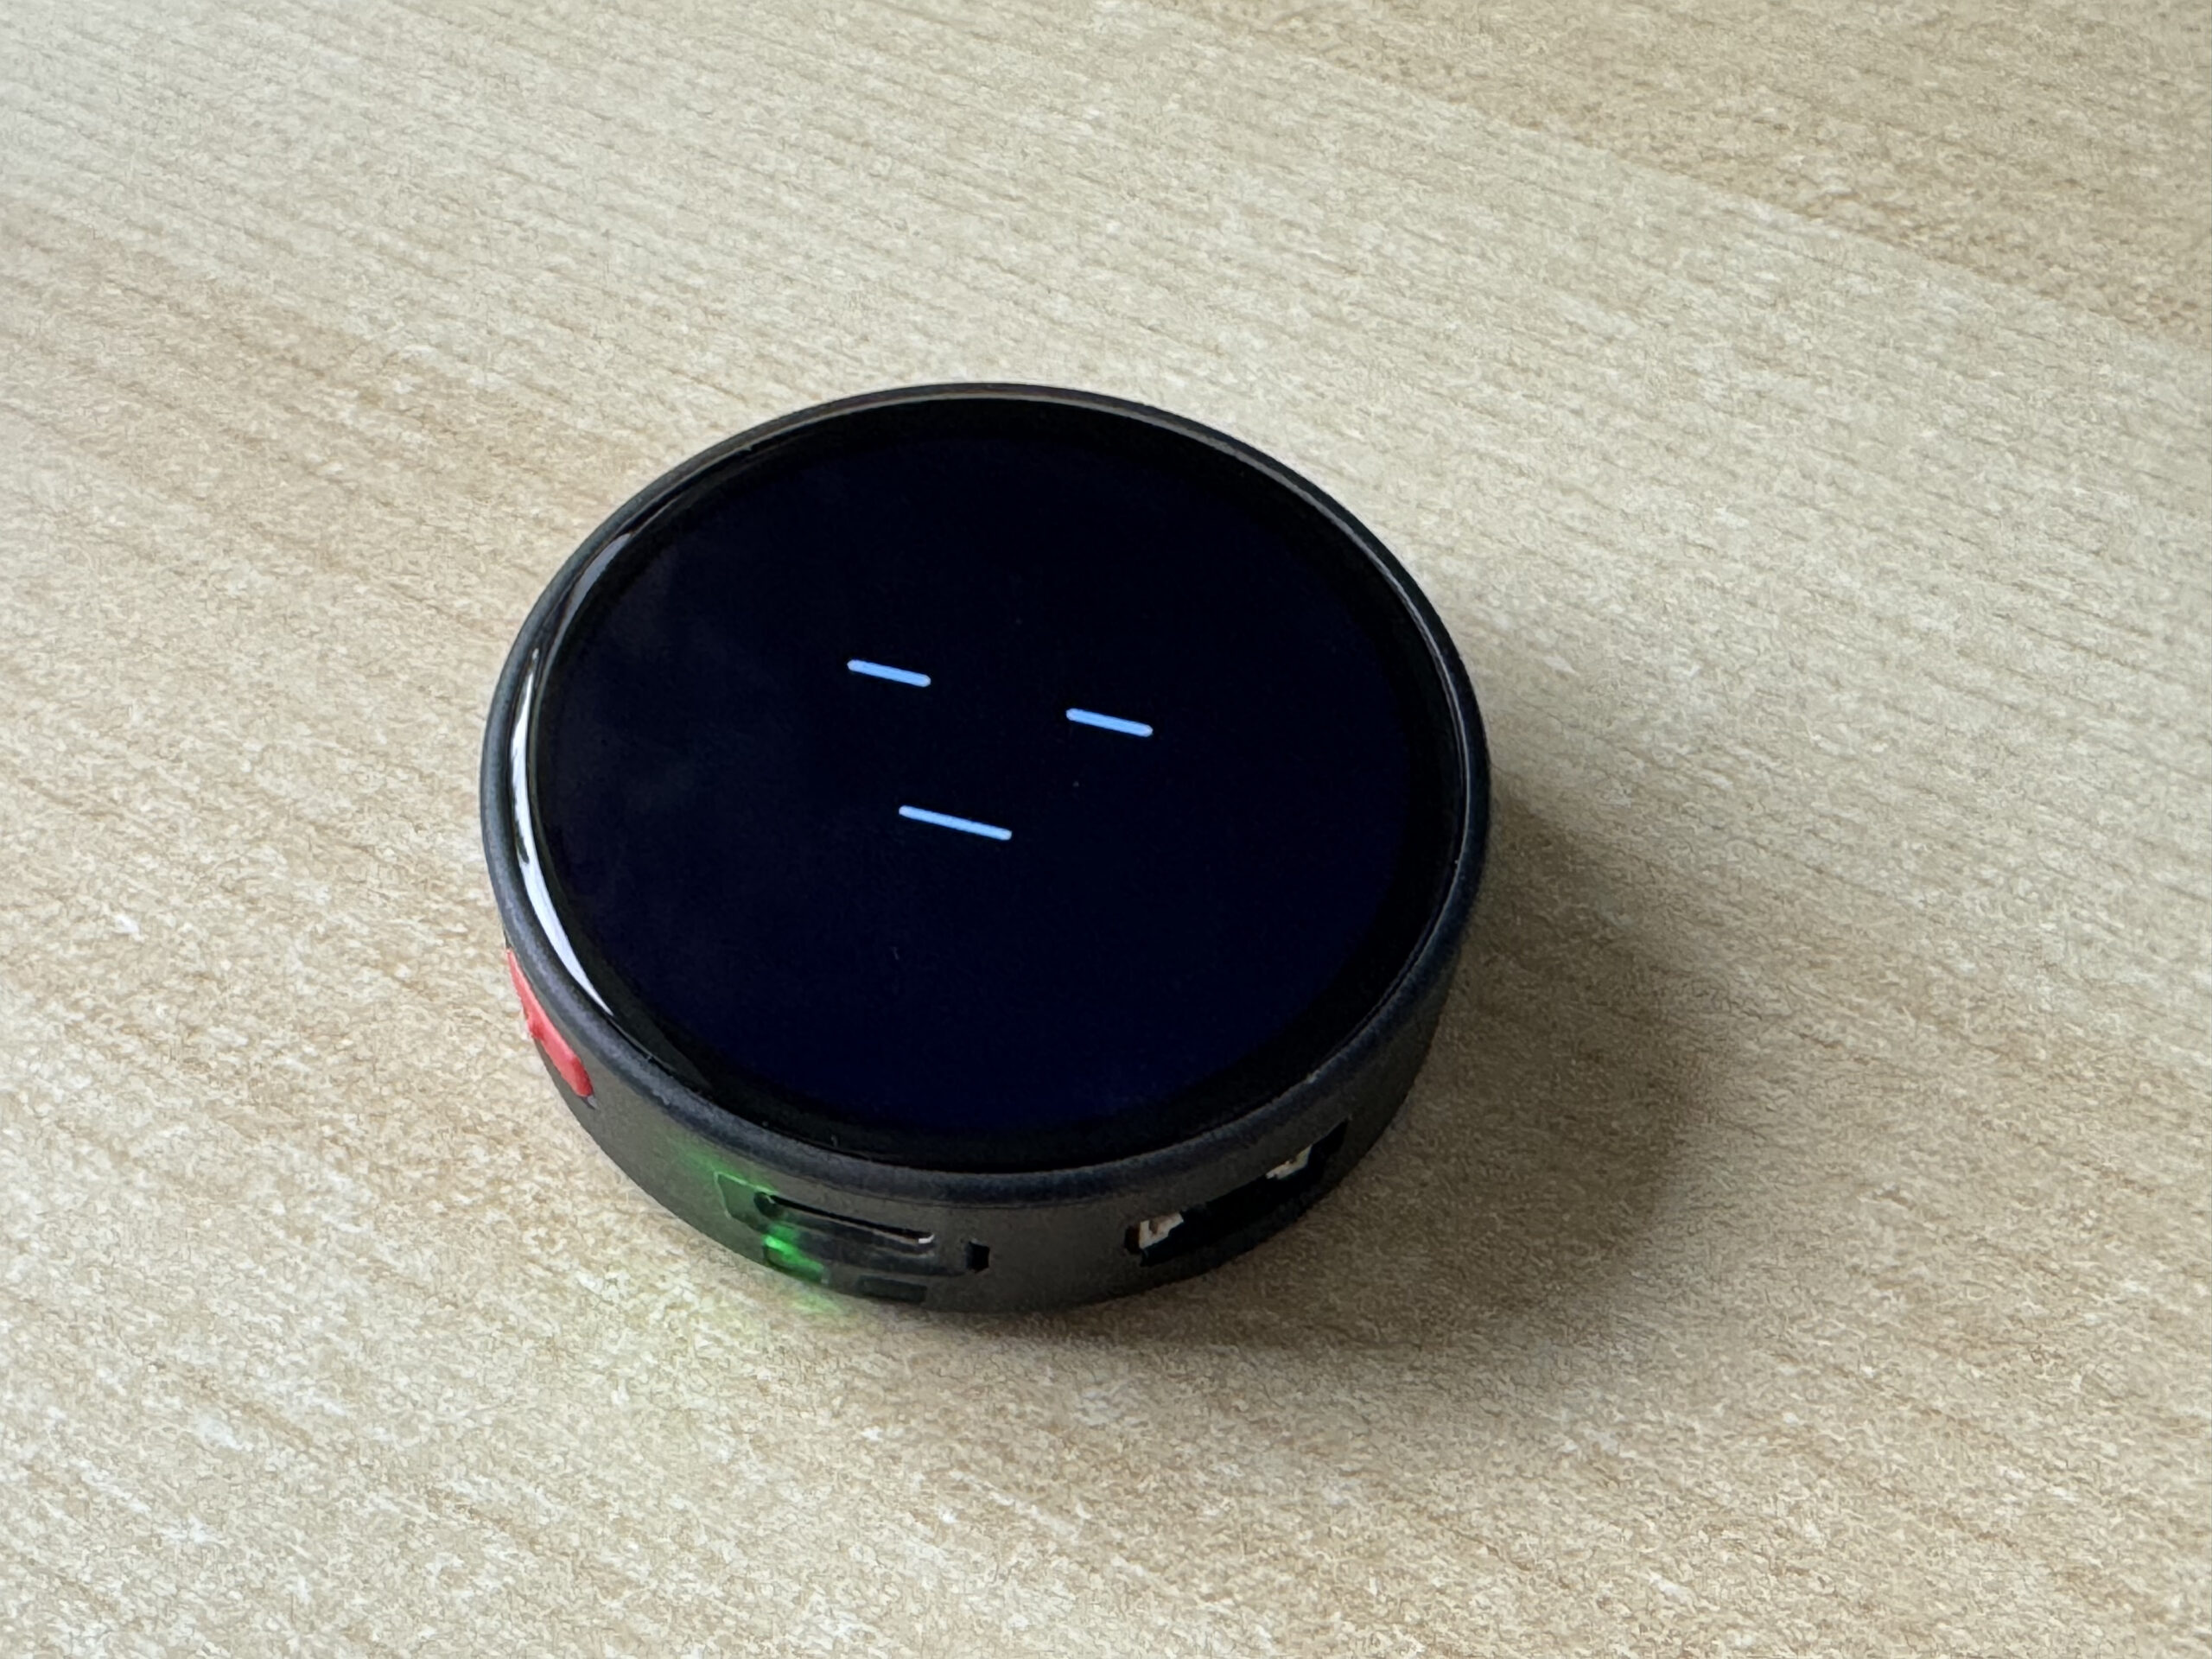
Die Stopwatch von M5Stack

Das Angebot selbst ist mittlerweile relativ unübersichtlich geworden und besteht aus einer Reihe unterschiedlicher Produktfamilien. Dazu gehören unter anderem die Core-, Stick-, Atom-, Stamp- und Paper-Geräte.

Für die Programmierung stellt M5Stack mit UIFlow eine eigene Entwicklungsumgebung zur Verfügung. Daneben können die Geräte unter anderem über das Arduino- und Espressif-Ökosystem programmiert werden. Da viele der Geräte auf Mikrocontrollern von Espressif basieren, ist daneben die Entwicklung mit Rust interessant. Für den ESP32 existiert mittlerweile eine entsprechende Rust-Unterstützung. Bei spezielleren Komponenten der M5Stack-Geräte kann es allerdings notwendig sein, entsprechende Treiber oder Abstraktionen selbst zu implementieren.

In Deutschland können die Geräte z. B. über BerryBase bezogen werden, auch wenn viele Geräte im Moment schnell ausverkauft sind.
Embedded Elasticsearch Server unter Java nutzen

Den freien Suchserver Elasticsearch kann man, wie das Wort Suchserver es dezent andeutet, als Server betreiben. Allerdings ist es manchmal nicht gewünscht einen dedizierter Server zu betreiben. In einem solchen Fall kann man den Elasticsearch-Server in eine Java-Applikation einbetten. Der sicherlich häufigste Fall für eine solche Einbettung ist dabei die Nutzung zu Testzwecken (z.B. Unit-Tests zum Test der Suchergebnisse). Im ersten Schritt sollte in das Java-Projekt die entsprechende Abhängigkeit zum Projekt hinzugefügt werden. In diesem Beispiel wird dabei auf einem auf Maven basierenden Projekt ausgegangen – in diesem muss die pom.xml entsprechend erweitert werden:

<dependency>
    <groupId>org.elasticsearch</groupId>
    <artifactId>elasticsearch</artifactId>
    <version>2.3.4</version>
</dependency>

Damit wurde Elasticsearch dem Projekt hinzugefügt. Nun muss der eigentliche Server im Java-Projekt gestartet werden. Dafür werden nur wenige Zeilen Quellcode benötigt:

Settings.Builder elasticsearchSettings = Settings.settingsBuilder()
    .put("http.enabled", "true")
    .put("path.data", "data")
    .put("path.home", "home");

Node node = nodeBuilder()
    .local(true)
    .settings(elasticsearchSettings.build())
    .node();

In diesem Beispiel werden im ersten Schritt die Einstellungen für Elasticsearch definiert. Dabei wird unter anderem der HTTP-Modus aktiviert. Wenn dieser deaktiviert ist, ist die Kommunikation per HTTP nicht mehr möglich. Stattdessen kann dann nur noch die Kommunikation über das Transport-Interface genutzt werden. Dieses Interface wird im Normalfall für die interne Kommunikationen zwischen einzelnen Elasticsearch-Clustern genutzt – allerdings ist eine Nutzung mit dem Elasticsearch-Java-Client ebenfalls möglich. Mit dem aktivierten Modus, ist die Entwicklung einfacher (z.B. für den Einsatz von Analyse-Tools) und die Konfiguration näher an der Praxis. Standardmäßig horcht der Elasticsearch-Server dabei auf dem Port 9200 – in diesem Beispiel wäre er über die URL:

http://localhost:9200

erreichbar. Nachdem die Einstellungen angelegt wurden, werden diese dem NodeBuilder übergeben, welcher schlussendlich den Elasticsearch-Server hochfährt. Nachdem dieser hochgefahren wurde, kann die Nutzung des selben beginnen.